

Локальный помощник
Черновики, разбор текста, помощь с кодом. Для Qwen или Llama проверим конкретную MLX- или GGUF-версию, русский язык и качество на ваших примерах.
Например: Avalon Q, RTX 5080, серверная память
Apple · настольный компьютер · под заказ
Локальные нейросети. Разработка. Работа с графикой.
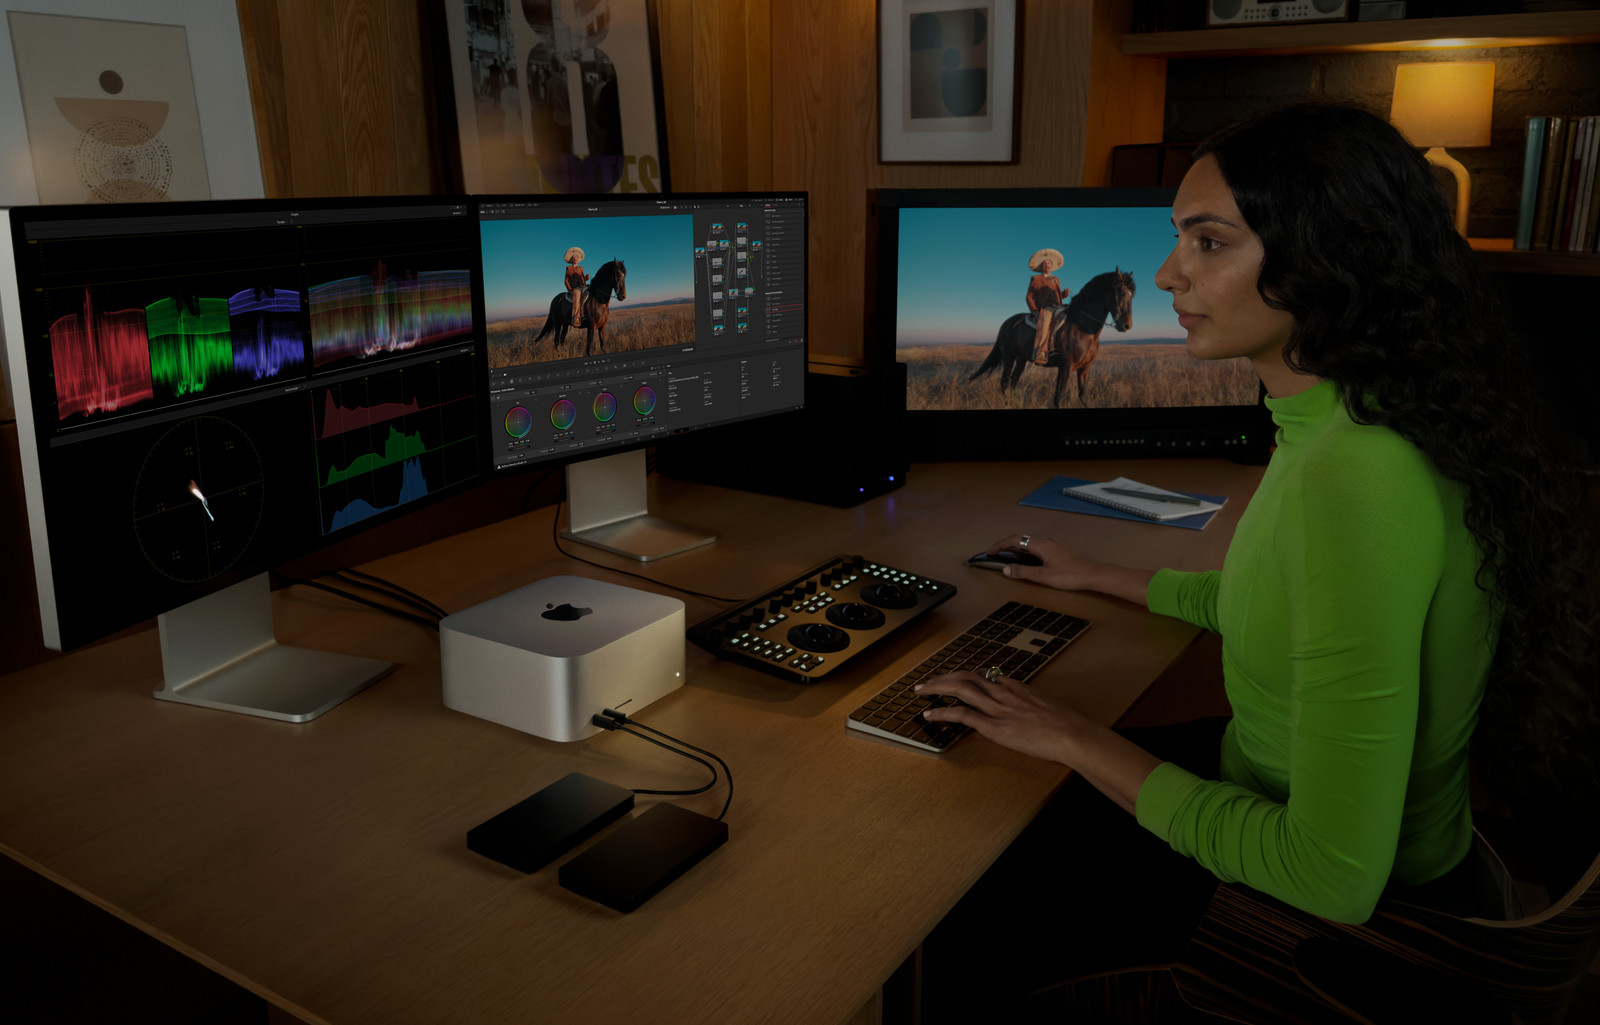
Компактный компьютер с Apple Silicon для приложений macOS и нейросетей, которые работают через Metal или MLX. Подберём память под вашу модель и рабочие проекты.
18 ядер CPU · 32 ядра GPU
Стартовая цена линейки. Стоимость выбранных памяти и SSD подтвердим в КП.
Выбрано: M5 Max · 36 ГБ · SSD 512 ГБ
Получить цену этой конфигурацииПоставка под заказ. Цена может меняться. Наличие, срок и гарантию подтвердим до оплаты; доставка рассчитывается отдельно.
Нужна CUDA? Сравните со станцией на NVIDIA ↗Ваш компьютер. Ваши инструменты.
Один компьютер для локальных моделей, кода и творческих проектов. Программный стек и объём памяти подбираются под вашу рабочую нагрузку.
Черновики, разбор текста, помощь с кодом. Для Qwen или Llama проверим конкретную MLX- или GGUF-версию, русский язык и качество на ваших примерах.
Поиск с ответами по базе знаний через RAG. Сам компьютер не создаёт базу знаний: нужны извлечение текста, индекс, права доступа и проверка ссылок в ответах.
Совместимые с Metal приложения, монтаж и локальные эксперименты. Для Blender проверяется поддержка сцены и движка; обязательный CUDA-плагин — причина выбрать NVIDIA.
Сравните Max и Ultra
Ориентиры стоимости компьютера под заказ. Объём памяти, накопитель и комплектацию зафиксируем в предложении. Максимальная память рассчитывается отдельно от цены «от».
Разработка и персональная работа
Точный состав и цену подтвердим в КП. Монитор, периферия и доставка не включены автоматически.
Настроить M5 Max →Большие локальные модели и тяжёлые проекты
Точный состав и цену подтвердим в КП. Монитор, периферия и доставка не включены автоматически.
Настроить M5 Ultra →Не только гигабайты
Сначала выбираем модель и формат весов. Затем — память с запасом под macOS, контекст и одновременно открытые приложения. Следующие примеры — расчётные ориентиры, не замеры скорости.
Отправная точка для персонального помощника. Сверяем движок и длину диалога.
Только веса при 4 битах: от 4,1 ГБ, без контекста и служебных данных.Карточка модели ↗Кандидат для более крупной локальной модели. Нужна проверка конкретной квантизации и KV-кэша.
Только веса при 4 битах: от 16,4 ГБ, без контекста и служебных данных.Карточка модели ↗Конфигурация для проверки 4-битной версии. Для длинного контекста и параллельных задач выбираем больший запас.
Только веса при 4 битах: от 35,0 ГБ, без контекста и служебных данных.Карточка модели ↗Большая MoE-модель: 22B активных параметров не означают 22B хранимых весов. Скорость требует отдельного теста.
Только веса при 4 битах: от 117,5 ГБ, без контекста и служебных данных.Карточка модели ↗Веса — только часть нагрузки. Единая память нужна также macOS, графике, контексту диалога и другим приложениям. SSD хранит модели, но не заменяет быструю память для их исполнения. Нижняя оценка весов: число параметров × битность ÷ 8. Реальные файлы, KV-кэш и рабочие буферы требуют дополнительной памяти. Возможность загрузить модель не гарантирует удобную скорость; для LoRA нужен отдельный расчёт.
Что фиксируем в заказе
Память выбирается при покупке. Доступные сочетания CPU, GPU и памяти зависят от исполнения. Максимальные параметры не относятся к одной базовой конфигурации.
Официальные характеристики Apple · проверено 1 ноября 2026 ↗Конфигурация · цена · срок
Укажите приложения, модель нейросети и бюджет. Если конфигурация уже выбрана, напишите чип, память, SSD и город доставки.
Оставьте контакты — уточним задачу и подготовим предложение. Без обязательств.
Заявка не обязывает к покупке. Комплектацию и итоговую цену согласуем до оплаты.
+7 (926) 899-94-77
Пн–Пт, 10:00–19:00 · Москва
От 345 000 ₽ — ориентир предложения M5 Max, от 789 000 ₽ — M5 Ultra. Максимальные объёмы памяти не входят в эти суммы автоматически. В КП укажем точные CPU/GPU, память, SSD, комплект, доступность и итоговую цену до оплаты.
Не нативно: Mac использует Apple Silicon и собственный графический стек. Совместимость конкретного приложения проверяется заранее. Для CUDA предложим другую платформу.
Нет. Возможность разместить модель в памяти и скорость её работы — разные вопросы. Нужны версия модели, точность весов, длина контекста и целевая нагрузка.
Возможность запуска зависит от формата модели и доступной GPU-памяти. Мы рекомендуем рассматривать 48–64 ГБ как отправную точку с запасом, а не обещать любой контекст на базовом Mac. Таблица показывает расчёт весов, не измеренный расход всей программы.
MLX LM поддерживает дообучение, в том числе LoRA и QLoRA. Память для обучения рассчитывают отдельно: размер модели, batch size, длина последовательности и число обучаемых слоёв меняют требования. Совместимость и качество проверяются на вашем датасете.
