


Короткий ответ: объём видеопамяти для локальной LLM выбирают не по одному названию модели. Нужно сложить память весов, KV-кэш контекста и рабочие буферы, а затем проверить конкретную конфигурацию под нагрузкой. 48 ГБ не означают «любая модель 70B», а 96 ГБ не гарантируют определённую скорость.
Материал подготовлен редакцией MinerWorld 19 октября 2026 года. Это методика предварительного подбора, а не отчёт о собственных испытаниях GPU. Ниже отдельно отмечены расчёты и характеристики производителей.
Сколько памяти занимают веса локальной нейросети
Первая оценка — число параметров, умноженное на число бит на параметр. Для модели с P миллиардами параметров приблизительный объём весов в десятичных гигабайтах равен P × b ÷ 8, где b — разрядность хранения. Это нижняя оценка: она не учитывает служебные данные формата, кэш и работу приложения.
| Размер модели | 16 бит | 8 бит | 4 бита |
|---|---|---|---|
| 7B | 14 ГБ | 7 ГБ | 3,5 ГБ |
| 14B | 28 ГБ | 14 ГБ | 7 ГБ |
| 32B | 64 ГБ | 32 ГБ | 16 ГБ |
| 70B | 140 ГБ | 70 ГБ | 35 ГБ |
Например, 32B при 4 битах дают 16 ГБ только на веса. Делать из этого вывод «достаточно карты на 16 ГБ» нельзя: памяти для остальных составляющих почти не остаётся. Аналогично 35 ГБ для весов 70B не являются обещанием комфортной работы на любой карте 48 ГБ.
Обозначения GB и GiB также различаются: 1 GiB — 1 073 741 824 байта. Сравнивайте доступную память и размер файла в одинаковых единицах. Кроме того, число «4 бита» в названии квантования не описывает все накладные расходы реализации.
Квантование позволяет уменьшить расход памяти, но требует поддержки формата и проверки качества на ваших заданиях. Документация Hugging Face по bitsandbytes описывает 8- и 4-битные варианты. Это возможности конкретного инструмента, а не универсальная совместимость всех файлов модели со всеми программами.
Почему длинный контекст меняет требования к VRAM
Память нужна не только для файла модели. При генерации сохраняются промежуточные ключи и значения внимания — KV-кэш. Его объём зависит от архитектуры модели, длины последовательностей, точности кэша и числа одновременно обслуживаемых запросов. Поэтому одну и ту же модель полезно проверять в нескольких режимах, а не только после загрузки в интерфейс.
«Модель запустилась» и «система выдерживает рабочий день отдела» — разные критерии. Если ассистент должен читать документы и одновременно отвечать нескольким сотрудникам, испытание коротким вопросом одного пользователя мало что доказывает. Особенно важно различать максимальный контекст, заявленный разработчиком модели, и контекст, который реально помещается в выбранную конфигурацию.
В официальном руководстве Hugging Face по KV-кэшу описаны выгрузка кэша и квантование. Эти способы экономии имеют компромиссы: передача данных и преобразования способны увеличить задержку. Проверять нужно весь режим работы, а не только отсутствие ошибки нехватки памяти.
Что ещё закладывать в расчёт
- Буферы вычислений и память выбранного движка инференса.
- Контекст и число параллельных сессий, включая длинные запросы.
- Другие приложения на GPU: графический интерфейс, рендер, обработку изображений.
- Работу с мультимодальными данными, если модель принимает изображения или видео.
- Резерв на реальную нагрузку, определённый испытанием, а не произвольным процентом из рекламного описания.
16, 32, 48 или 96 ГБ: какую видеокарту рассматривать
Таблица ниже помогает составить список кандидатов. Она не является списком гарантированно совместимых моделей: окончательный выбор зависит от разрядности, контекста, ПО и требуемой скорости.
| VRAM | Когда рассматривать | Что проверить в первую очередь |
|---|---|---|
| 16 ГБ | Первый локальный проект с небольшой квантованной моделью и одним пользователем | Полный расход памяти с рабочим контекстом; остаётся ли резерв после загрузки весов |
| 32 ГБ | Проект, которому тесно в 16 ГБ, но не требуется максимальный объём профессиональных GPU | Не занимает ли выбранный формат почти всю память только весами |
| 48 ГБ | Рабочая станция с более крупными моделями или совмещением ИИ и графики | Память кэша, совместимость ПО, питание и охлаждение конкретной карты |
| 96 ГБ | Задача с большой потребностью в памяти GPU после измерения её расхода | Полная серверная или рабочая конфигурация, а не только цена ускорителя |
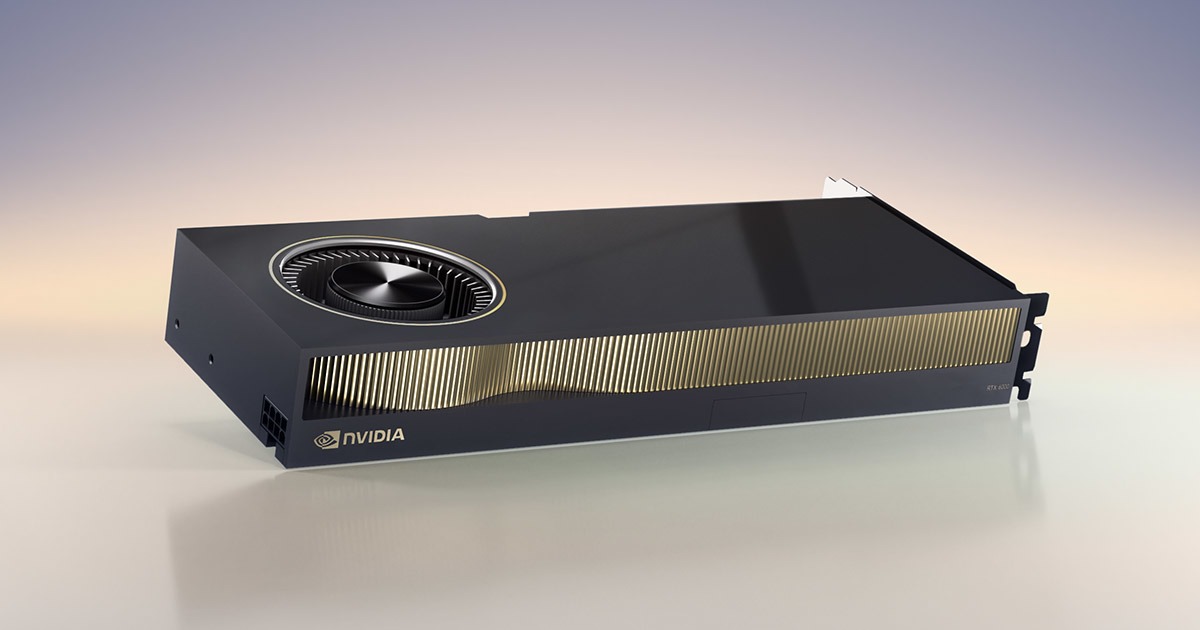
Для сравнения оборудования: RTX PRO 5000 Blackwell 48 ГБ и RTX 6000 Ada 48 ГБ относятся к разным поколениям. Одинаковый объём памяти не делает их одинаковыми по скорости, поддерживаемым операциям и цене. Характеристики серий опубликованы у NVIDIA для RTX PRO 5000 и RTX 6000 Ada. В нашем предложении PRO 5000 указан вариант 48 ГБ, не 72 ГБ.
У RTX PRO 6000 Blackwell Server Edition заявлено 96 ГБ GDDR7 — см. спецификацию NVIDIA. Серверное исполнение нельзя покупать как произвольную замену настольной карты: сначала согласуют платформу, питание и охлаждение.
Три сценария: как не переплатить за неподходящую конфигурацию
Личный помощник и знакомство с локальными LLM
Сначала выберите конкретную модель и несколько типичных вопросов. Измерьте качество ответа и задержку на доступном оборудовании или в тестовом окружении. Если короткие задания решает небольшая модель, покупка максимального объёма памяти может не дать соразмерной пользы. Но экономия на карте с недостаточным запасом способна ограничить контекст уже в первом рабочем проекте.
Корпоративный помощник по документам
Составьте обезличенный тестовый набор: короткий вопрос, длинный документ, несколько одновременных запросов. Зафиксируйте время до первого токена и общую задержку ответа. Для RAG отдельно учитывайте компоненты поиска и эмбеддингов: они не исчезают из архитектуры от покупки большой видеокарты. Требования к безопасности данных и доступу пользователей также решаются программно и организационно.
Дообучение модели
Не переносите расчёт инференса на обучение. При обучении появляются дополнительные данные состояния и промежуточные вычисления; метод адаптации существенно меняет картину. Для LoRA или QLoRA требуется отдельная конфигурация задания. В техническом запросе укажите метод, длину последовательности и размер пакета, а не только число параметров модели.
Можно ли заменить VRAM обычной оперативной памятью
Частичная выгрузка в RAM иногда позволяет выполнить задачу, которая не помещается целиком на GPU. Это не превращает оперативную память в равноценную видеопамять: меняется путь движения данных и может падать скорость. Перед покупкой решите, допустим ли такой компромисс по задержке. Если важна большая общая память компактной системы, сравните архитектуры в нашем материале «DGX Spark или ПК с RTX».
Чек-лист испытания перед заказом GPU
- Зафиксируйте точное название и версию модели, формат весов и лицензию.
- Укажите движок, его версию и поддерживаемую платформу.
- Проверьте рабочую длину контекста и максимальный ожидаемый запрос.
- Измерьте память при нужном числе одновременных сессий.
- Сравните время до первого токена, скорость продолжения и качество ответа.
- Зафиксируйте модель GPU, доступную память, настройки и результат: чужой скрин без условий не заменяет протокол.
- Сверьте корпус, блок питания, разъёмы и охлаждение с точным артикулом.
Частые вопросы
Хватит ли 16 ГБ для локальной нейросети?
Для части небольших моделей и режимов — возможно. Ответ зависит от формата весов, контекста и приложения. Проверяйте полный расход памяти, а не только размер скачанного файла.
Поместится ли 70B на 48 ГБ?
Простой расчёт даёт около 35 ГБ для 4-битных весов 70B, но к нему добавляются накладные расходы и кэш. Это основание для проверки, а не гарантия запуска с любым контекстом и числом пользователей.
Две карты по 24 ГБ равны одной на 48 ГБ?
Не автоматически. Приложение должно уметь распределять вычисления и данные между GPU. Совместимость, межсоединение и результат зависят от платформы; общий объём на коробках не доказывает пригодность системы.

Читайте также
Готовы выбрать майнер?
Ответьте на 3 вопроса — подберём модель под ваш бюджет и условия. Или посчитайте окупаемость под свой тариф на электричество.
Комментариев нет.