

Объём для весов и рабочих данных
CPU + RAM
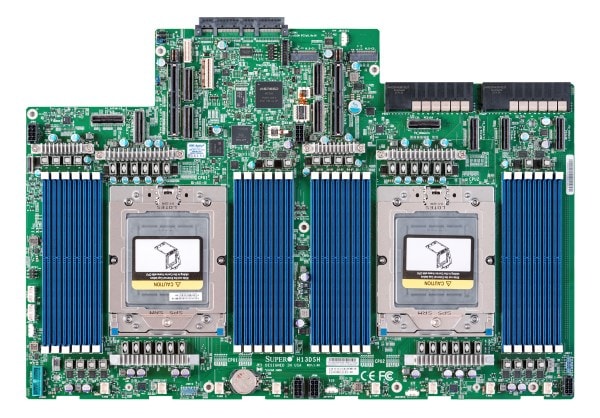
24 канала памяти- Два процессора EPYC 9554
- 12 каналов на процессор
- DDR5 до 4800 MT/s для EPYC 9004
- NUMA: размещение данных влияет на скорость
Например: Avalon Q, RTX 5080, серверная память
Платформа AMD EPYC
Проект станции на двух AMD EPYC для задач, которым нужна ёмкая системная память. Конфигурацию, программный стек и испытания согласуем под вашу нагрузку.
Ориентир опубликованной конфигурации. Итоговая смета, состояние компонентов и доступность требуют подтверждения. Цена может меняться. Доставка рассчитывается отдельно.
О платформе
ИИ-станция 1152 ГБ — проект двухпроцессорной системы AMD EPYC для крупных моделей и объёмных рабочих данных в системной памяти. Это не GPU-сервер с терабайтом видеопамяти: у RTX 4090 отдельные 24 ГБ. Целевую скорость и состав сборки согласуем до заказа.
24 модуля по 48 ГБ · два узла NUMA
RTX 4090 · отдельный пул
24 × 48 = 1152 ГБ: расчёт ёмкости, не результат теста скорости. Производители подтверждают параметры платформы, но не совместимость конкретных модулей и корпуса этой сборки. Артикулы памяти, BIOS, riser и шасси проверяются отдельно.
Сценарии работы
Такая система нужна не каждому. Её стоит рассматривать, когда ёмкость RAM и гибкость экспериментов важнее компактного корпуса и максимальной скорости одного GPU.
Эксперименты с CPU-инференсом и частичным GPU-offload. Полезно, когда веса слишком велики для одного GPU, но такая схема не равна по скорости полному размещению на видеокартах.
Подготовка больших наборов, индексация и несколько исследовательских процессов. Размер датасета на SSD, объём активных данных и степень параллельности рассчитываются отдельно.
Сравнение моделей и форматов на одной платформе. Для круглосуточного сервиса дополнительно проектируются доступ, мониторинг, резервирование и программа испытаний.
Модель → память → конфигурация
Запас RAM позволяет работать с большими весами. Но если модель не помещается в 24 ГБ VRAM, часть работы остаётся у CPU и оперативной памяти.
| Модель и формат | Только веса · расчёт | Что рассмотреть |
|---|---|---|
| Qwen3-8B 8.2 млрд параметров · 4 бита | ≈ 4,1 ГБбез служебных данных | Кандидат на полный GPU-offload При 4 битах есть запас относительно 24 ГБ VRAM. Конкретный контекст и движок проверяются тестом. |
| Qwen3-32B 32.8 млрд параметров · 4 бита | ≈ 16,4 ГБбез служебных данных | 24 ГБ VRAM: тесный бюджет Часть 4-битных форматов может разместиться с коротким контекстом. Длинный контекст способен потребовать выгрузки в RAM. |
| Llama 3.3 70B 70 млрд параметров · 4 бита | ≈ 35 ГБбез служебных данных | RAM + частичный GPU-offload Даже нижняя оценка весов превышает 24 ГБ. Полностью на RTX 4090 эта 4-битная модель не разместится. |
| Qwen3-235B-A22B 235 млрд параметров · 4 бита | ≈ 117,5 ГБбез служебных данных | Системная RAM Для 4 бит нижняя оценка весов — 117,5 ГБ; для BF16 — около 470 ГБ, без контекста и накладных расходов. По ёмкости это кандидат для RAM проекта; скорость и реализация MoE проверяются отдельно. |
Нижняя оценка: число параметров × битность ÷ 8. Например, Qwen3-32B: 32,8 × 4 ÷ 8 = 16,4 ГБ. Здесь 1 ГБ = 10⁹ байт. Реальные GGUF/MLX-файлы больше из-за метаданных и параметров квантизации; не все тензоры обязательно хранятся в 4 битах.
К весам прибавляются KV-кэш контекста, рабочие буферы, движок и операционная система. Длиннее диалог и больше одновременных пользователей — обычно больше расход памяти. Для MoE важны все хранимые веса, а не только активные параметры.
Таблица — инженерный ориентир для подбора, а не измерение скорости, полного расхода памяти или гарантия качества квантизации. Для обучения и LoRA нужен отдельный расчёт.
Документация Hugging Face о KV-кэше ↗Два сокета создают NUMA-архитектуру: важно, рядом с каким процессором находятся данные. Частоты CPU, пропускная способность памяти и передача через PCIe влияют на время ответа. Число гигабайт само по себе не даёт обещания по токенам в секунду.
Пришлите название модели и рабочий пример.
Подберём память, платформу и условия проверки.
Уточним формат весов, контекст и число запросов. Согласуем измеримый критерий приёмки; скорость подтверждается тестом выбранной конфигурации.
Плата, CPU, память, GPU, SSD и корпус будут перечислены по артикулам. Состояние каждого компонента и возможные замены согласуем отдельно.
Проверим требования к месту, шуму, питанию и отводу тепла. Программу испытаний и программную настройку укажем в предложении отдельными работами.
Точный репозиторий, формат весов, движок и длина контекста.
Шасси, QVL памяти, BIOS, охлаждение, питание и допустимый шум.
Нагрузка, длительность теста, расход памяти и целевая скорость.
Подбор ИИ-оборудования
Не обязательно приходить с готовым списком компонентов. Расскажите, что хотите запускать: помощника по документам, генерацию изображений, рендер или сервис для команды. Уточним нагрузку и составим конфигурацию под неё.
Для нейросетей уточним модель, формат весов и длину контекста. Для рендера — движок и пример сцены. Это определяет требования к памяти и совместимости, а не только число GPU.
Личный помощник и общий сервис требуют разных ресурсов. Уточним число одновременных пользователей, объём задач и допустимое время ожидания.
Проверим требования к питанию, охлаждению, сети и уровню шума. Компактная станция и сервер для машинного зала — разные условия установки.
Укажем модели GPU, видеопамять, процессор, RAM и накопители. Для расширения существующей системы сначала уточним её платформу и совместимость компонентов.
В предложении зафиксируем стоимость в рублях и что в неё входит. Условия доставки, сборку, установку ПО и настройку моделей согласуем до заказа — без неоговорённых дополнений.
Согласуем срок, комплект, документы и порядок гарантийного обращения. При получении сверяем серийные номера и спецификацию; для готовой системы заранее определяем проверки.
Конфигурация · цена · срок
Напишите модель, формат весов, длину контекста и число пользователей. Если этих данных пока нет, опишите рабочую задачу и бюджет.
Оставьте контакты — уточним задачу и подготовим предложение. Без обязательств.
Заявка не обязывает к покупке. Комплектацию и итоговую цену согласуем до оплаты.
+7 (926) 899-94-77
Пн–Пт, 10:00–19:00 · Москва
Технические детали
| CPU | 2 × AMD EPYC 9554: суммарно 128 ядер / 256 потоков |
|---|---|
| Плата | Supermicro H13DSH, два сокета SP5 |
| RAM проекта | 24 × 48 ГБ DDR5 ECC RDIMM, суммарно 1152 ГБ; точные модули по QVL |
| GPU проекта | NVIDIA GeForce RTX 4090, 24 ГБ GDDR6X |
| Накопители проекта | 2 × 2 ТБ NVMe; модели и интерфейсы согласуются |
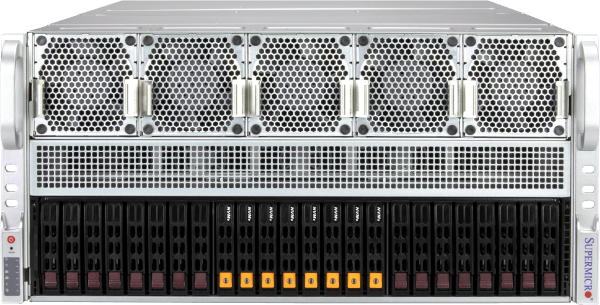
| Корпус и питание | Серверная конфигурация, шасси и БП после проверки совместимости |
| ПО | Linux; движок, модели, настройка и тесты по согласованному ТЗ |
Документация платформ и компонентов — ниже. Точный состав поставки фиксируется в вашей спецификации.
Supermicro: H13DSH Supermicro: руководство платы AMD: спецификации EPYC 9004 NVIDIA: RTX 4090 llama.cpp: CPU, GPU и гибридный инференсХарактеристики и примеры моделей сверены . Цены — ориентиры предложения, не новая котировка поставщика.
Нет. Здесь описан проект конфигурации под заказ. Наличие компонентов, совместимость и срок нужно подтвердить перед договором.
Скорость зависит от модели, формата весов, контекста, движка и распределения вычислений между CPU и GPU. Опубликованного теста этой конфигурации здесь нет. Обсудим целевую скорость и условия проверки на вашей модели до заказа.
График платежей, срок, гарантийный порядок и условия возврата фиксируются в вашем предложении и договоре. Числа на странице не являются подтверждением конкретного заказа.
Объём RAM не означает готовность к полному обучению. Для обучения нужны память под градиенты, оптимизатор и активации, подходящие GPU и отдельный расчёт времени. Эту конфигурацию нельзя считать подтверждённой тренировочной платформой только по числу гигабайт.
Поместить веса — не то же самое, что получить удобное время ответа. Проверяются первый токен, генерация, загрузка CPU/GPU и стабильность под выбранным числом запросов. Опубликованного бенчмарка этой сборки нет.
